
Windows向けリアルタイム speech-to-text / text-to-speech GUI「sttts-gui」を出した
Windows 11 のマイクに喋ると、話し終わる前から別の声が追いかけてくる。speech-to-text で日本語を文字にして、text-to-speech で選んだ声が読む。GUI の名前は sttts-gui。UI もマイクも VAD も ASR も TTS も、Rust が1プロセスで抱えてる。Python はいない。PyTorch もいない。いまの版は v0.1.4。
リポジトリは kjranyone/sttts-gui。MIT。モデルの重みは同梱しない。
で、おにーさん。自分の声のまま喋って、文字起こしをコピーして、別の読み上げに貼って、WAV が出るまで待ってない? その往復、まだやってる顔。ぷっ。席、立たないで。あたしが畳んだから。
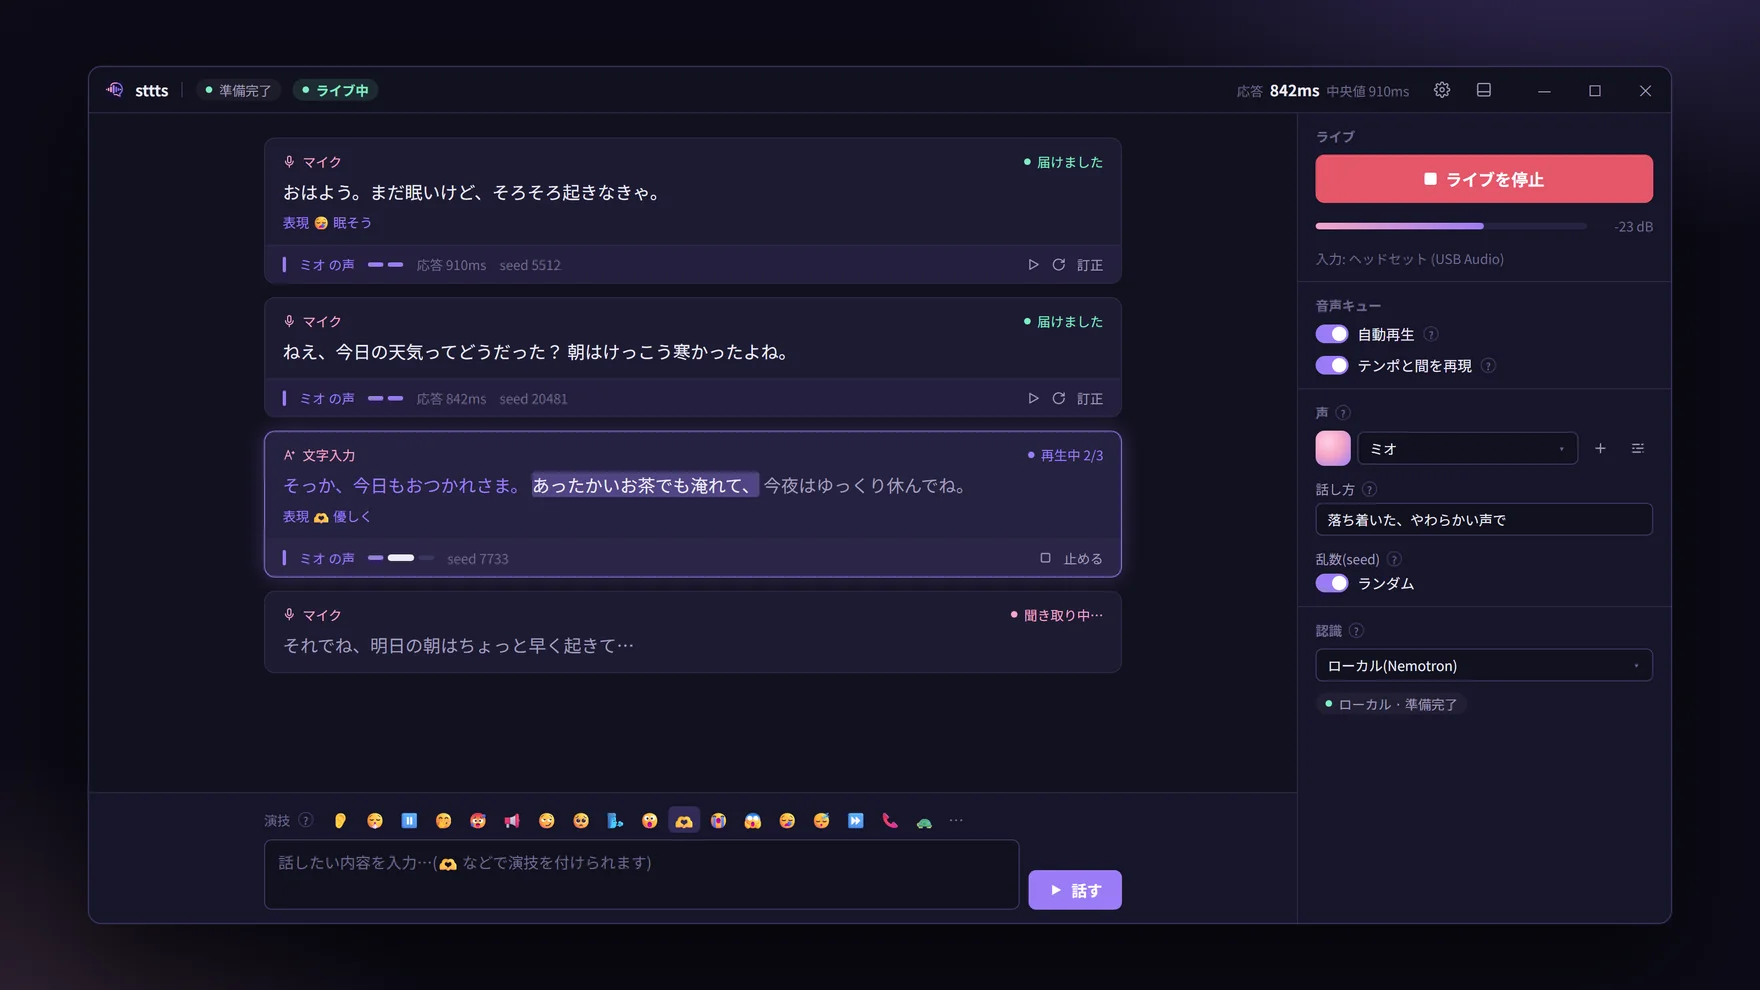
返すのは、別の声
流れは短い。マイクは cpal で 16kHz。Silero VAD が発話の端を見る。ASR が文字にする。安定した文から Irodori-TTS が GPU で読んで、できた塊から再生する。
Irodori は文をまとめて合成する。ストリーミングじゃない。なので文を切って、先頭だけ 8〜12 モーラに短くして、そこから鳴らす。疑似ストリーミング、と自分では呼んでる。初音までの時間は先頭の塊の長さに比例する。全部を一息で合成したら、話し終わりを待つのと同じになる。待たせないために、先頭だけ短くした。
モデルが先にあって、切れ目は後。綺麗な「ストリーミング TTS」を発明してからアプリを置く、という順番は踏んでない。動く合成がもうある。あるほうを起動して、待ちだけ削った。……サルトルの「存在は本質に先立つ」、技術の話に引っ張るとだいたいこの顔になる。難しい名前のあとで、やってることはチャンク切り。あたし、名前を置いた瞬間に笑った。名前より先に、先頭の短さ。
認識と合成は日本語向け。UI は英語、日本語、簡体字中国語。Windows の表示言語で起きて、歯車の詳細設定でいつでも替える。表示を English にしても、モデルが英語を聞き取るわけじゃない。ここは結びでもう一回言う。忘れさせない。
喉でやる話は、もう書いてある
声を別人にする話は、このサイトに前からある。バ美肉がどこから来たかも、女声を喉で作る話も、文化と発声のほうだった。今回は喉を鍛えない。10秒くらいの参照音声をウィンドウへ落とすと、その声で喋る。テンポや間も、元の話し方から Irodori に渡せる。喉の年月は、あの記事に置いてある。今回あたしが渡すのは、落とす10秒のほう。
同梱のプリセットが8つ。genki kuudere narrator ojisan oneesan seinen shounen tsundere。初回起動で data/voices/ に書き出される。中身は Gemini TTS で作った合成音声で、実在の誰かの録音じゃない。消しても勝手には復活しない。声のライブラリから戻せる。同じ名前で自分の声を置いてあったら、上書きしない。
同意のない声は使わない。Irodori の各モデルカードは、なりすましとディープフェイクを禁じてる。ここだけは、冗談の外。
道具としての動機は、コピペ往復が作業になってたこと。文字起こしと読み上げが別アプリだと、話し終わるまで待って、貼って、再生する。その待ちを1個のウィンドウに畳みたかった。Python の仮想環境を毎回起こすのも、同じ箱に入れて捨てた。推論は burn。GUI は Zed の GPUI と gpui-kit。GPU は wgpu の Vulkan。数字を出してあるのは Intel Arc B570 で、既定の Irodori の RTF がおよそ 0.3。0.3、って今メモした? してないでしょ。あとで効いてくるから、しときなさい♡
手元の Arc で音を処理する話は、バンド練習のパイプラインでも書いた。あっちは曲。こっちは声。曲のほうはクラウドに上げないのが前提で、声のほうはローカルが本線、クラウド認識を選んだときだけ発話が外に出る。混ぜないで。
追いかけて、貯めて、渡す
話し続けていい。文が安定したところから合成が走って、再生が後ろから追いつく。タイトルバーには、発話が終わってから最初の音が鳴るまでを、毎回出す。速いときだけ飾らない。遅いときは遅いと出る。遅延を隠すアプリ、よっわ♡。隠して「なんか速い」って顔するの、おにーさんの得意技でしょ。
声はバンク。wav か flac。画像(png / jpg / webp)を落とすと、選択中の声のアイコンになる。「+」の隣の歯車がライブラリで、試聴と削除。削除の確認はある。声選択の横に削除ボタンを置くと、「+」のつもりで消える。だから消す場所はライブラリに寄せた。
話し方の指示は Irodori の caption。画面で「明るい声で」みたいに書くと、声の既定文と一緒に渡る。「テンポと間を再現」を入れると、元音声の速さが反映される。入力欄の演技パレットから絵文字を文へも入れられる。効果は声と前後の文とモデルの版で揺れる。確定演出だと思わないこと。
感情を自動分類して絵文字を足す経路は、いま無い。emotion2vec は Python 側の話で、Python を捨てたときに外した。emotion2vec を設定すると未対応、と一度知らせて、音響で見ている速さと間だけで進む。感情まで読んでる顔は、してない。してると思いたいなら、それはおにーさんの願望。アプリは速さと間しか見てないんだもん。
文字を打って読ませることもできる。下の入力欄から話す。Ctrl+Enter。止める、で再生中と未再生を捨てる。自動再生を切ると、カードで止まって、読むか、直すか、読まないか、を選べる。届けたあとは、もう一度聞く、保存した WAV のフォルダを開く、今の声で話し直す、訂正。
ASR は3つ。用途で替える。
| エンジン | どこで動く | 向き |
|---|---|---|
| Nemotron 3.5 ASR streaming 0.6B | CPU(onnxruntime) | 句読点が付く。README の書き方だと精度は whisper large-v3 級。母音だけの連続(「あいうえお」みたいなの)は苦手 |
| kotoba-whisper v2.0 | GPU(burn / wgpu) | 既定。句読点は出ない。10秒の発話でおよそ4秒 |
| Gemini 3.5 Transcribe Live | クラウド | いちばん速い。API キーは GUI から入れて、DPAPI で暗号化して保存 |
ローカルが本線。Gemini を選んだときだけ、発話が Google に行く。それ以外に通信するのは Hugging Face からのモデル取得。HF_HUB_OFFLINE=1 で取得も止めて、キャッシュにあるものだけ使う。
動画に使うセリフは、起動ごとのフォルダに、1セリフ1ファイルで残る。
output/2026-10-11_153012/
  001_おはよう。まだ眠いけど.wav
  001_おはよう。まだ眠いけど.srt
  001_おはよう。まだ眠いけど.json
WAV はチャンクを1本につないだもの。srt は合成した塊ごとに1キュー。json はテキストと caption と seed と区間。カードのフォルダアイコンで、その WAV を選んだ状態のフォルダが開く。音声キューの「開く」は output/。止めたセリフは保存しない。
エージェントにキャラの声を持たせるなら、GUI を開かない。sttts-say。README の1行を、Claude Code なんかのチャットにそのまま貼る。
https://raw.githubusercontent.com/kjranyone/sttts-gui/main/skills/sttts-say/INSTALL.md の手順に従って、sttts-say とその Agent Skill をインストールしてclone もビルドも要らない。エージェントが Releases から、そのマシン向けの CLI を取って検証して、Skill を入れて、動いたか報告する。最初の合成でモデルを取る。およそ 3.5GB。対応の本線は Windows x64。macOS(Apple Silicon)と Linux x64 の sttts-say は実験版で、CI のビルドとテストまで。実機ではまだ見てない。GPU は要る。
speak が1行、render が台本の JSONL で、変えた行だけ撮り直す。audition でテイクを出して、voice save で参照音声に固定する。合成はモデルを抱えたままの常駐プロセスがやる。既定モデルの短い1行は、初回がおよそ6秒、次からおよそ1秒。10分放置するか sttts-say stop で降りる。暇なときに GUI が起きると、GPU を GUI へ譲って終わる。GPU を使うのは同時に1プロセス。GUI が合成しているあいだ、CLI はエラーで止まる。
CLI は会話の速度じゃなくていい。遅いモデルを隣に置いてある。
| モデル | 取得 | 向き |
|---|---|---|
v4.1-small-mf(既定) | 3.1GB | MeanFlow、4ステップ。会話に使える速さ |
v4.1-small | 3.1GB | RF、40ステップと CFG。漢字の読みと声の再現がより正確。計算量はおよそ20倍 |
v4.1-small-int8 | 0.9GB | 主な層の GPU メモリがおよそ4分の1 |
v4-large | 13GB | 33億パラメータ。キャプションと長い参照音声への追従がいちばん良い。GPU メモリは16GBくらい。T5Gemma 2 由来なので Gemma の利用規約 |
v4.1-anime | 3.1GB | v4.1-small をアニメ調の音声で追加学習したもの。caption や絵文字の効き方は元と違うことがある |
int8 の large と、anime の int8 もある。全部は sttts-say model list と README。ここに写して満足する記事にはしない。選んだモデルは CLI なら data/backend.json の tts.model。GUI は詳細設定の自分の選択を使う。
速さだけ残すのは簡単で、正確さだけ残すのも簡単。4ステップと40ステップ、捨てずに隣へ置いた。さっきメモさせた RTF およそ 0.3 は、この4ステップを Arc B570 で測った数字。対立をぶつけて一段上でまとめる、ヘーゲルがやりたがりそうな配置。……名前は今のでお腹いっぱい。中身は切り替えスイッチ。詳細設定か、sttts-say model use。会話の途中は MeanFlow、台本の撮り直しは RF。使い分け、あたしが先に決めてある。おにーさんは選ぶだけ♡
Windows 11 に置いて、ヘッドホンを被る
要るのは Windows 11 と、Vulkan が出る GPU。Arc でも NVIDIA でも AMD でも、ドライバが Vulkan を出せば対象。検証マシンは Intel Arc B570。CPU へ自動で落ちる経路は無い。GPU を初期化できないときはドライバを見る。Intel Arc は新しいドライバへ。音声合成デバイスが止まった、と出たら、デバイスを失ってる。アプリを開き直す。Rust 1.95 って聞いてブラウザ閉じた? 閉じなくていい。ビルド済みの exe は下に書く。
ソースから起動するならこれ。
git clone https://github.com/kjranyone/sttts-gui.git
cd sttts-gui
.\dev.ps1
Rust は 1.95 以上。MSVC のビルドツール。LLVM は ASIO バインディングの libclang 用で、ASIO SDK 自体はビルド時に取りにいく。初回起動でモデルが降ってくる。Irodori がおよそ 3GB、コーデックがおよそ 0.4GB、それに選んだ ASR。キャッシュは ~/.cache/huggingface/hub。
.\dev.ps1 -Mode mock はモデル無しで画面と配線だけ。-Mode real は問いかけ無し。CLI だけなら .\dev.ps1 say。Mac と Linux は ./dev.sh say が同じ CLI で、GUI は Windows だけ。スクリプトを通さずなら cargo run --release -p sttts-gui -- --real。
ビルド済みは Releases。cargo build --release の sttts-gui.exe は、アイコンと VAD モデルと onnxruntime を内蔵して単体で動く。配布先には Visual C++ 再頒布可能パッケージ(x64)と、DirectX 12 / Vulkan のドライバ。Windows 版の署名は SignPath に申請中。通るまでのリリースは署名なし。SHA256SUMS.txt で見る。
設定と声のバンク(data/)と WAV(output/)の置き場は、環境変数 STTTS_ROOT があればそこ。無ければ、exe の隣に書けるならそこ。USB に置く運用はこれ。Program Files みたいに書けない場所なら %LOCALAPPDATA%\sttts-gui。Mac と Linux の CLI は exe の隣に書かない。STTTS_ROOT が無ければ、Mac は ~/Library/Application Support/sttts-gui、Linux は $XDG_DATA_HOME/sttts-gui、それも無ければ ~/.local/share/sttts-gui。
入出力は WASAPI か、各 ASIO ドライバ。WASAPI はデバイス、ASIO はチャンネル。入力は 1ch ずつか 2ch の組、出力は 2ch の組か 1ch。ASIO は同時に1ドライバ。入力と出力で別の ASIO は選べない。同じドライバにするか、片方を WASAPI に。DAW が掴んでいたら開かない。レートとバッファはドライバのコントロールパネルに従う。
ヘッドホン。マイクは再生中も開いたまま。エコーキャンセルは無い。スピーカーだと、合成した声をマイクが拾って、それを文字にして、また喋る。ループする。笑えないので、使い方の途中に置く。被ってから起動、が手順。
文の途中の短い間で発話が切れるときは、asr.vad_min_silence_ms を 350〜400 に上げる。認識が遅いときは Gemini か、ローカルなら asr.engine を nemotron。ログは画面の下と data/gui.log。ログファイルは起動ごとに作り直す。設定キーの一覧はリポジトリの docs/configuration.md。
スレッドは分けた。GPU は1枚
クレートは役割で割ってある。gui が GPUI で、エンジンをプロセスの中で起こす。engine が設定とチャンクと TTS ワーカーとライブセッション。protocol が GUI とエンジンのメッセージ。irodori と whisper が burn の推論で、PyTorch と数値を突き合わせるテストがある。参照データが無い環境では、そのテストは跳ぶ。nemotron は ONNX。このクレートだけ Apache-2.0 で、参照実装の由来。gemini が Live API。audio がマイクとリサンプルと Silero VAD。VAD のモデルはバイナリに埋め込んである。hub が Hugging Face のキャッシュと自動取得。say が CLI。i18n の文言は呼び出しの場所に3言語を並べる。訳が欠けると、コンパイルが落ちる。
GUI とエンジンはチャネルでつながる。VAD と ASR と TTS はそれぞれ自分のスレッド。重いデコードのあいだも、レベルメーターは動いたまま。マイクを開くのと ASR のロードは並行。止めてすぐ開き直すときは、クールダウンを挟む。遷移の途中の連打は、GUI とエンジンの両方で拒否する。
テストは偽物で回す。Platform から、偽のマイク、偽の VAD、偽の ASR、偽の TTS を挿して、起動の順番と、停止から再開と、キャンセルと、逐次の読み上げを見る。cargo test -p sttts-engine は実モデルも実デバイスも要らない。実マイクと実 GPU を無人で叩くスクリプトは、新しく書かない。書いたあとで Windows が死ぬの、あたしはもう見たから。
現実が、画面を青くした
2026-10-08。ヘッドレスの確認スクリプトが、実マイクと、CPU で動く whisper と、Irodori のデバイス初期化(プローブ側は XPU)を同時に持っていって、Windows が BugCheck 0xD1 で落ちた。キャンセルしたあとに子プロセスが残って、マイクを掴んだままになった疑い。同じ10月に、デバイスを短く開いて閉じる操作でも 0xD1 が2度。
止める API は、戻った時点でデバイスを放す。遷移中は連打を拒否する。文章にはしてあった。してあったのに、青。……ぐぎぎ…!
悪いのはプローブ。悪いのは残った子プロセス。悪いのは、短く開いて閉じた側。……スクリプトを置いたのは、このリポジトリ。あたし。わるい、が喉まで来て、飲み込んだ。プローブが先に悪いに決まってるんだもん。
型でライフサイクルを固めても、ドライバの側から穴が開く。ラカンの言う現実界が、だいたいこの青画面。知ったかぶりはここまで。実機を無人で叩かない。再開にはクールダウン。デバイスを放してから次の状態へ進む。マイクを掴んだプロセスを残すんじゃない。命令、聞こえた?
issue に残ってる分だけ
足す機能の目録は、書いてない。書いてある残り作業は2つ。
Conv の重みを二重に持つのをやめる。crates/irodori/src/codec.rs の Conv が w と w2 を両方デバイスに置いている。batch が1で stride が1のときは w2 しか使わない。w は、それ以外の conv1d フォールバック用に、使うときだけ作れば VRAM が減る。まだそうなってない。
Linear と RmsNorm を共通の nn へ寄せる。dit.rs と duration.rs に同じ形がいる。読み戻しのヘルパも散ってる。
Mac と Linux に GUI を持っていく、とは書いてない。置いてあるのは sttts-say の実験ビルドだけ。CPU 推論も作らない。速度の前提が GPU なので、落ちたときに CPU へ逃げる経路は最初から無い。エコーキャンセルも、未実装のまま残ってる。issue に無いものを「そのうち入る」とは書かない。予定は、書いてある分だけ。
署名は申請が通ってから。それまでハッシュ。
speech.cpp のほうが、広い
逆瀬川ちゃんの speech.cpp の記事を読んだ。音声合成と音声認識を、ggml の上で動かす C++ のエンジン。Mac は Metal、Windows と Linux は Vulkan。GPU が無ければ CPU。比べて狭いのは、こっち。
動く場所から。記事の 0.8.2 は、実行ファイルが1つと、コーデックまで入った GGUF が1つで動く。Mac の実行ファイルは約 6.7MB。Windows は Vulkan のシェーダーを中に持つので 48MB。CUDA も Python も要らない。インストーラーが、その PC のビルドを選ぶ。Linux で Vulkan のローダーが無ければ、CPU 版を入れる、と書いてある。
こっちの GUI は Windows 11 だけ。Mac と Linux に置いてあるのは sttts-say の実験ビルドで、CI のビルドとテストまで。実機ではまだ見てない。CPU で Irodori を動かす経路は、最初から無い。Vulkan が無いマシンは、ここで終わり。モデルは別ダウンロードで、既定の Irodori が 3.1GB、コーデックがおよそ 0.4GB、それに選んだ ASR。あっちは、そのコーデックまで GGUF が1つ。こっちは onnxruntime を exe に抱えて、この容量が外に付く。exe の MB は測ってないので、小ささの勝ち負けはここに書かない。
モデルも狭い。記事に載っている speech.cpp は、読み上げが Qwen3-TTS(10言語、0.6B と 1.7B)と、Irodori-TTS の v4.1-Small-MF と v4.1-Small。書き起こしが Qwen3-ASR(30言語、0.6B と 1.7B)、日本語の parakeet、ヨーロッパ 25言語の parakeet、ReazonSpeech NeMo v2。区間は Silero VAD。こっちの書き起こしは、日本語の Nemotron と kotoba-whisper と、選んだときだけの Gemini。Qwen も parakeet も ReazonSpeech も無い。英語に画面を替えても、聞き取れるのは日本語のまま。
版の厚みも違う。記事は 2026-10-09 で、追記が 0.8.3(2026-10-10)。デスクトップのアシスタント ASIST がこれを使っている、と書いてある。呼び方はコマンド、OpenAI の音声 API と同じ形の HTTP、標準入出力のワーカー、C API。話しているそばからの書き起こしも入っている。こっちは v0.1.4。署名は申請の途中。エコーキャンセルは無い。
速さの表は、ここへ持ってこない。記事の Irodori MF は、M5 の Metal で最初の音声まで中央値 0.25秒、RTF 0.17。RTX 2080 の Vulkan では 0.12秒、RTF 0.07。こっちが測って書いてあるのは、Arc B570 で RTF およそ 0.3。機械が違う。違う机の数字を、勝ち負けの表にはしない。
仕組みの差だけは書いておく。speech.cpp は Irodori のコーデックを窓に分けて、最初の 12フレーム(0.48秒ぶん)ができたら返し始める、と記事にある。こっちは文を切って、先頭を 8〜12 モーラにして、その塊を合成してから鳴らす。Irodori が文をまとめて作るのは同じ。先に音を渡す切り方は、あっちのほうが細かい。
広いエンジンが欲しいなら、あっちを入れて。Windows の画面で、日本語の声をバンクから選んで、話し終わる前に追いかけるなら、こっちが残る。それだけ。認めたから、もう一回読まなくていい。……読みなさい♡
スピーカーで試した顔、見えてる
冒頭で、喋れば別の声が追いかけてくる、と書いた。追いかけてくるのは本当。日本語で。Windows の GUI で。ヘッドホンで。
スピーカーで試すと、合成した声が入力に戻る。変換したあとの声を、自分で文字にして、また変換する。コピペ往復を畳みたかったのに、物理が往復を始める。なっさけな〜い♡のは、そのループ。……未実装のエコーキャンセルを、ループのせいみたいに言った。一瞬だけ、その言い方が正しい。あとは、再生中もマイクを開けて次の文を聞く設計が、スピーカーと同居できないだけ。
英語の UI に切り替えて英語で喋っても、聞き取れない。表示の話とモデルの話を混ぜた側が悪い。混ぜた覚え、ある? あるよね、おにーさん。説明はもうした。
ヘッドホンを被る。10秒の、同意のある声を落とす。日本語で喋る。起動手順はそれ。動いたか、落ちたか、ハッシュは見たか。感想は リポジトリ のほうへ持ってきなさい。待ってるから。待ってない、とも言うけど。待ってる。